
一、这个项目解决的是什么问题
架构图这件事,难的不是画,是画完就过期。手画一张白板图,三个月后没人敢照着改;用画图软件摆一堆方框,摆完自己都不想看第二遍。代码就在仓库里,结构就在那里,可要把结构说清楚,还是得有人坐下来摆位置、连箭头、标边界,摆一下午。
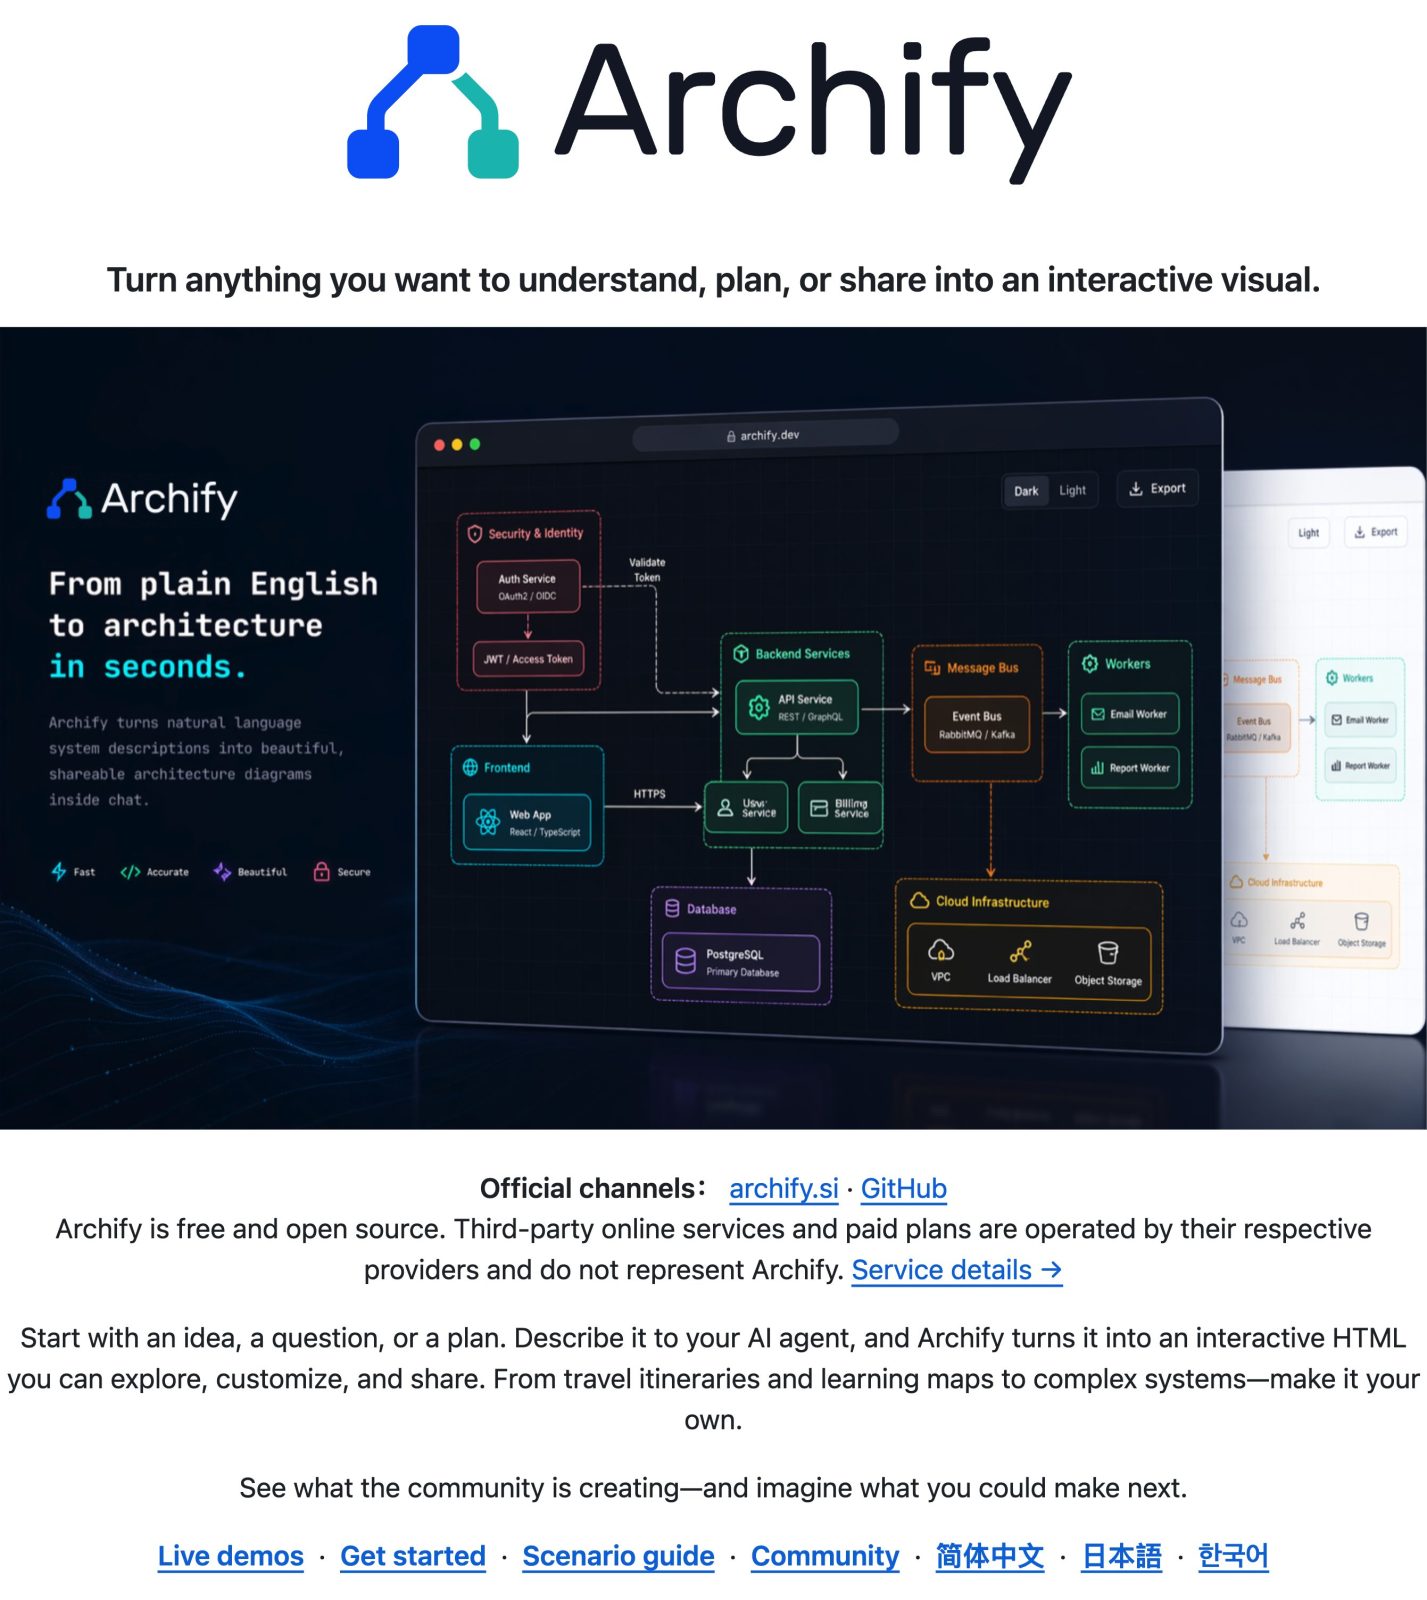
Archify 换了个入口:不打开画图软件,直接跟 AI 说一句。给它一段描述,或者让它去读一个仓库,它生成一个自包含的 HTML,打开就能点节点看细节、顺着路径走、按角色过滤。它不是独立应用,是装在 Claude Code、Codex、Cursor、opencode 里的 agent skill,干活的是你已经在用的那个 AI 助手。
二、核心设计机制
它的产物是一份带类型的 JSON 中间表示,再由渲染器生成单文件 HTML。中间这层是重点:每个图类型都有自己的 schema,agent 先按 schema 写 JSON,再用内置的校验器和布局规则检查,检查不过就带着具体问题回去改。校验覆盖 schema、布局、HTML 与 SVG、路径、标签与路径的间距,全部通过才允许交付。
交付是原子的。候选文件先在同一个目录里渲染、检查,通过了才替换目标文件,所以不会出现改一半、图打不开的情况。失败时 validate --json 和 deliver --json 会返回稳定的规则编号、具体对象、实测证据和受支持的修复动作,而不是一段堆栈让你猜。skill 里给的修复轮次是两轮,超了就该换思路而不是继续硬试。
布局是它自己判断的,不是通用自动排版。层级、间距、走线、强调由 agent 决定,共享的端点会确定性地散开,而不是把一堆箭头全堆在同一个中点上。这一点直接决定了图好不好看,也是它明确不提供「通用自动布局」的原因——通用算法排出来的图,通常只能说没排错。
交互是照着你写的关系来的。聚焦某个节点、看它的上游下游、走一条指定路径、比较两种角色,用的都是你写进去的节点和关系,不会自己补出一条拓扑,也不会声称这是运行时的影响。
三、功能拆解
图类型有十种。架构图管组件、服务、存储、边界;工作流管参与方、顺序、分支、异常;时序图管调用与返回;数据流管来源、转换、存储、敏感边界;生命周期管状态、重试、终止;ERD 管表、字段、主外键和关系基数;类图管接口、成员、继承与实现;树管单父层级;时间线把事件放到一条按比例的时间轴上;瀑布图看一次请求或一次 agent 运行的时间花在哪。选不准就问命令行,guide 会按你的描述给建议。
explainer 是另一条路。不是每个问题都该画成一张图,有些答案是一页纸:先给结论和理由,然后每个面板回答一个问题,表格、步骤、图、代码混排。步骤就摆在它走过的那张图旁边,读到哪里哪一块亮起来。这种页面同样是一个 HTML,四种样式,明暗两套主题。
交互那层给了快捷键。问号打开图例,斜杠搜节点并聚焦,R 探一条有向路径,L 比较角色,M 打开总览雷达,F 进演示模式,S 换视觉样式,T 换主题,E 打开导出。链接可以固化视图,焦点、上下游、关系、路径、角色对比都能写进地址里,发给同事打开就是同一个视角。
导出这块,PNG 可以直接进剪贴板,也能下静态或动态格式;走过一条路径之后可以导出 1200×630 的路径分享卡,整张图保留作背景;长图能出 PNG、WebP、JPG,也能直接打印成 PDF。
四、适合谁,不适合谁
适合要把一个系统讲给别人听的人。评审前出一张能点的图,比贴一段文字强。适合接手陌生仓库的人,让 agent 读一遍再画一张高层运行时架构,8 到 12 个核心组件、一条主路径、外部依赖、信任边界,比翻目录快。适合写事故复盘的人,时间线和瀑布图正好对上「什么时候发生了什么」和「时间花在哪」。也适合做方案对比,Architecture Delta 能拿两份校验过的快照比出新增、删除、修改、移动。
不适合想找一个画图软件替代品的人。它明确不做 WYSIWYG 编辑,你不能拖着方框改位置。不适合想要 Mermaid 那种「粘一段文本出图」的人,它不解析 Mermaid,也不做通用自动布局。不适合要托管分享的人,没有在线协作空间,分享的方式是把 HTML 文件发出去。也不适合不愿意跟 AI 反复对话的人,它的工作方式就是一句话一句话改。
五、几个需要提前知道的限制
第一,它是 skill 不是应用。装的位置是各个助手的 skills 目录,Claude Code 在 ~/.claude/skills/,Codex CLI 在 ~/.agents/skills/,opencode 在 ~/.config/opencode/skills/ 或 .agents/skills/。装在哪个助手,就只能在哪个助手里用。
第二,Claude.ai 那条路能力打折。上传 zip 到 Settings 里的 Capabilities,能不能跑完整渲染取决于沙箱里有没有 Node.js。没有的话就退化成提示词驱动的架构图,画得出来但校验和渲染那套用不上。
第三,节点多了会挤。图是它按 schema 生成的,位置由 agent 判断,节点一多就容易密。项目自己的建议是把细节放进卡片,而不是继续加边。想让图更好读,正确做法是砍组件数量、把次要关系收进卡片。
第四,它不会自己装更新。检查更新只是 GET 一个固定的清单,用来提示有新版本,服务器看不到版本号、项目、提示词、账号或设备信息,也不会自动下载。不想让它联网,把 ARCHIFY_UPDATE_CHECK_DISABLED 设成 1。
第五,交互不承诺运行时真相。上下游、路径、角色对比都是照着写进去的关系走的,不是从监控或链路追踪里读出来的。时间线和瀑布图里的时间,除非来自日志或追踪,否则只是示意。
六、项目现状
版本 v3.2.0,星标九万八千五百多,Apache-2.0,早期以 MIT 发布的授权继续有效。支持的接入面有 Claude Code、Codex CLI、opencode、Cursor、Claude.ai、项目知识库,另有 Hermes Agent 和 DeepSeek Harness 两个社区集成。3.1 加了 ERD、类图、树、时间线、瀑布图五种类型。仓库里带 11 个已校验的场景和它们的 JSON 源文件,可以直接拿来对照。具体能力和安装位置以项目文档为准。
七、常见问题
问:它是独立软件吗?
答:不是。它是 agent skill,装在你用的 AI 助手的 skills 目录里,靠那个助手来生成和校验。产物是自包含 HTML,看图的人不需要装任何东西。
问:图能不能自己改?
答:能,但方式是在对话里改。加一个组件、把认证挪到左边、高亮回滚路径,都是说一句让 agent 改 JSON 源再重新渲染。它没有拖拽编辑,也不打算做。
问:节点太多挤在一起怎么办?
答:减少组件数量,把细节挪进节点卡片,而不是继续加连线。项目自己在示例提示词里就写了「把支撑细节放进卡片,不要加更多边」,这是它推荐的用法。
问:能不能直接读我的仓库?
答:可以,让它分析当前仓库再画高层运行时架构就行,还能要求带源码证据。带证据的节点会标出来源编号,点开是钉在某个提交上的文件和行号。
问:分享出去别人能看吗?
答:能,一个 HTML 文件,交互跟着文件走。但外部链接和地图这类要联网,离线打开时那些链接点不动。
问:会不会偷偷检查更新?
答:会检查,但只 GET 一个固定清单,用来显示可选提醒,不上报版本、项目、提示词、账号或设备信息,也不自动安装。不想联网就设环境变量关掉。
下载地址
夸克网盘(永久有效):https://pan.quark.cn/s/617df5aa4b40
本教程由「宝藏星球屋」整理,更多软件、游戏、开源项目都在 https://cbge.top。


暂无评论内容