
一、这个项目解决的是什么问题
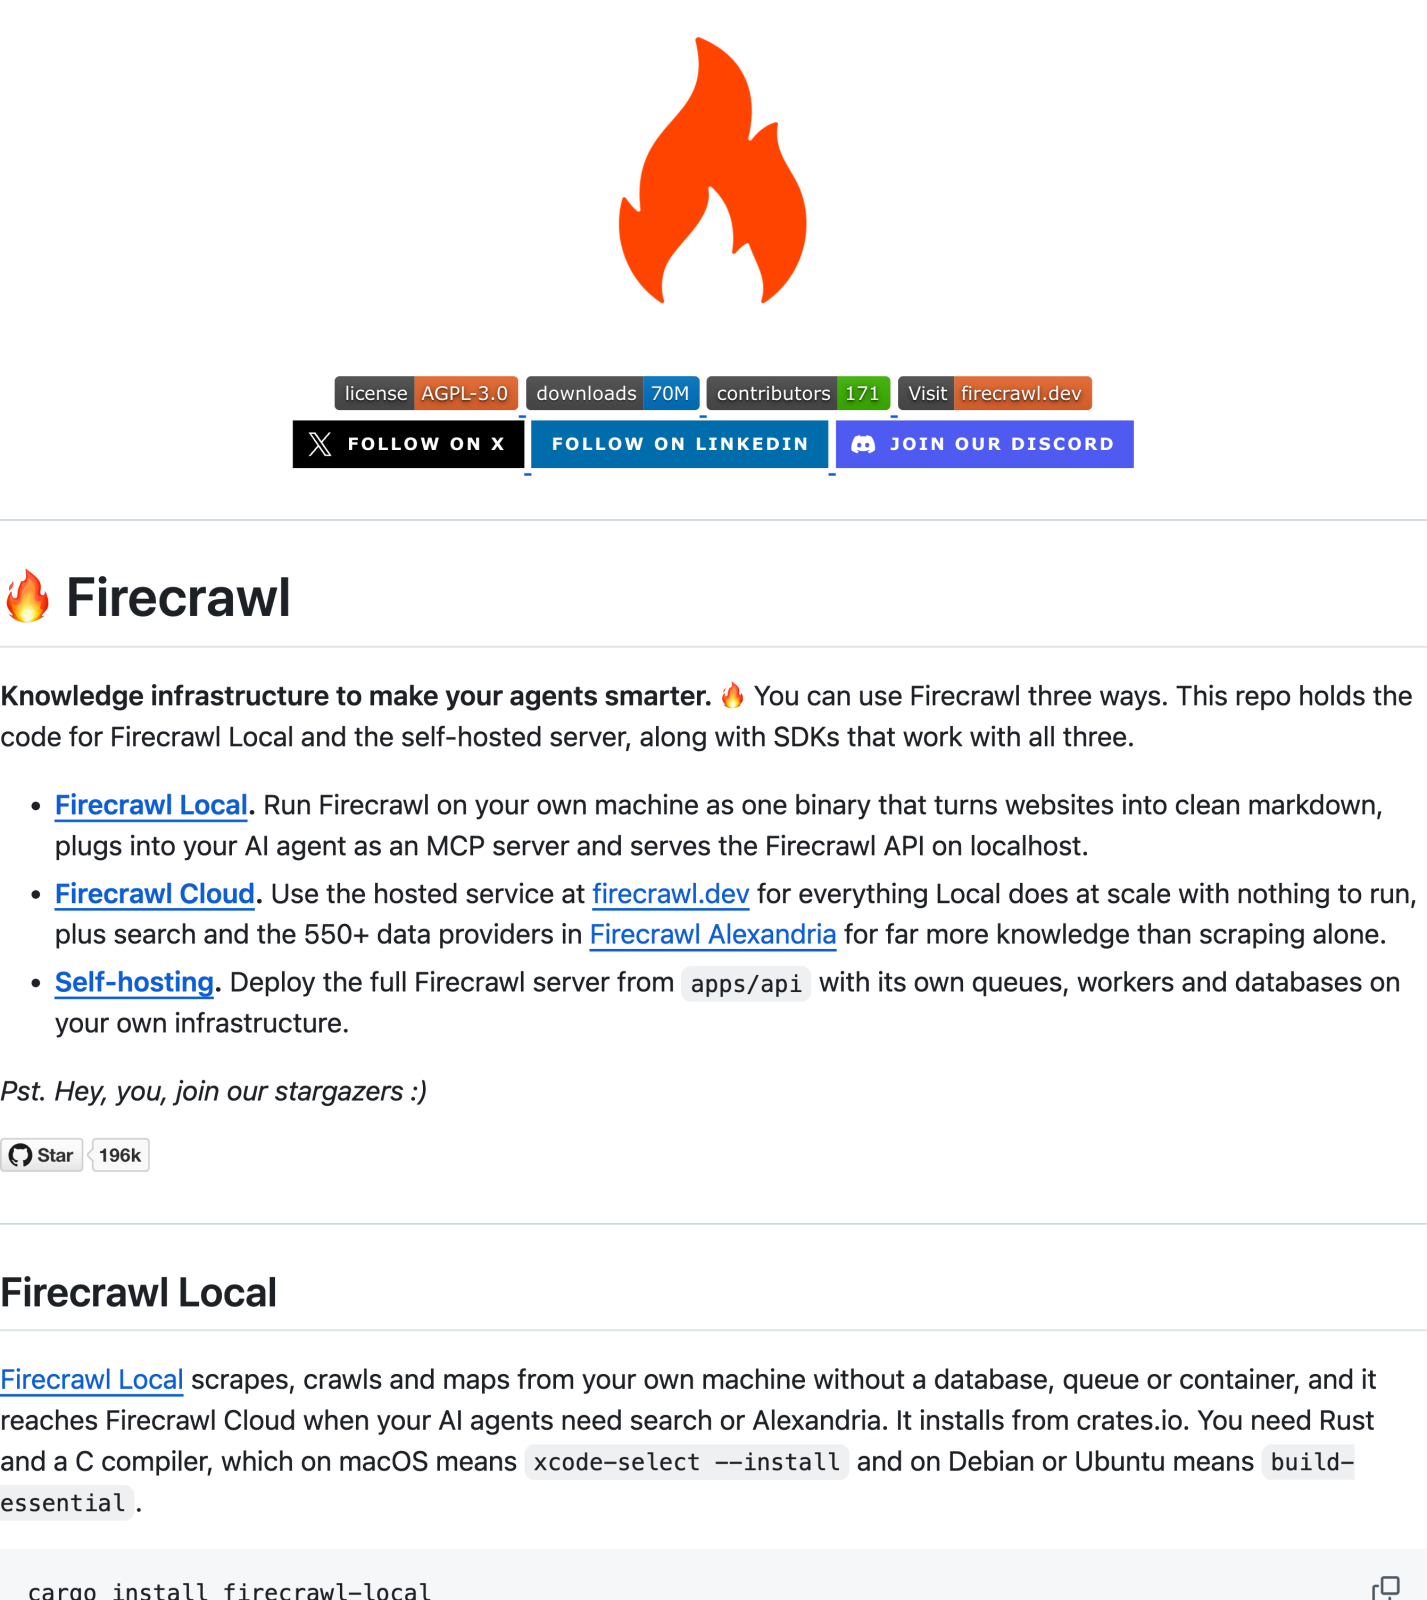
想让 AI 读网页,第一步就卡住。直接喂 HTML,一半 token 花在导航栏、广告位、cookie 提示和一堆内联样式上;自己写爬虫,又要处理 JS 渲染、翻页、PDF、编码、去重,写完还不保证正文抽得干净。Firecrawl 做的就是这一层:把网页变成干净的 Markdown,整站也能一批一批抓下来,抓完直接丢给模型或者塞进知识库。
它有三种用法,最好一开始就分清。第一种是 Local,装一个单二进制在自己的机器上跑,不需要数据库、队列和容器。第二种是 Cloud,官方托管的服务,本地能做的它都能做,还多出搜索、Alexandria 那批数据源,以及 Interact、Agent、Monitor 这些要开浏览器的功能。第三种是 Self-hosting,把仓库里那套完整服务连同自己的队列、worker 和数据库部署到自己的基础设施上。三种用法共用同一套 API 和 SDK,代码基本不用改。
二、核心设计机制
Local 的目标是「一个二进制解决抓取」。抓单页、抓整站、列 URL、批量抓,全在本机跑,不需要外部依赖。需要 JS 渲染的页面,它用你机器上已经装好的 Chrome 或 Chromium 渲染;PDF 和 Office 文档也在本地解析。装的方式是从包仓库装,所以要有 Rust 和 C 编译器:macOS 先跑 xcode-select --install,Debian 或 Ubuntu 先装 build-essential。
这里有个默认行为必须说清楚。按默认设置,单页抓取在你机器上打不开时,会改由 Firecrawl Cloud 去取,结果里带一个 source 字段标成 firecrawl-cloud。这种云端调用不需要账号,但有速率限制;执行 firecrawl-local login 之后就挂在你自己账号下。想让所有请求都留在本机,把环境变量 FIRECRAWL_CLOUD 设成 off,代价是那些本机取不到的页面就真的取不到了。
「什么在哪跑」这件事,项目自己列了一张对照表,边界很清楚。抓单页、抓整站、列 URL、批量抓、解析 PDF 与 Office,本地和云端都行,云端多出结构化 JSON、摘要、截图和浏览器操作。搜索在本地是借道云端完成的,不需要账号。Alexandria 要在 firecrawl-local login 之后才能用。Interact、Agent、Monitor 只有云端有。Self-hosting 那套服务带 Redis、PostgreSQL 和一个浏览器服务,用 Docker Compose 起,Alexandria 不在里面。
三、功能拆解
抓单页最常用。加 --markdown 直接打印正文的 Markdown,适合先看看效果再决定要不要写脚本。抓整站用 crawl,带 --limit 限页数、--out 指定输出目录,一页一个 Markdown 文件。map 只列 URL 不抓内容,适合先摸清站点结构再决定抓哪一片。批量抓是给一批已知 URL 用的,SDK 里会自动轮询任务直到跑完。
接进 AI 助手靠 init。它会去你机器上找 Claude Code、Claude Desktop、Cursor、Windsurf、Gemini CLI、Codex,把 Firecrawl Local 作为 MCP 服务器写进各自的配置,写之前先备份每一份配置。这个 MCP 服务器本身要 Node.js 22 或更新。写完要重启对应的工具。之后抓取、抓整站、列 URL、批量抓这几个工具跑在你机器上,其余 Firecrawl 工具走云端。
serve 是把本地变成 API 服务器。它在 3002 端口应答 Firecrawl v2 API,为 Firecrawl 写的代码不用改就能跑在本地,本地路由不需要 API key。任何官方 SDK 把 api_url 指到 http://localhost:3002 就能用,Python 里就是 Firecrawl(api_url="http://localhost:3002"),然后正常调 scrape。
云端那侧的能力值得单独说。结构化 JSON、摘要、截图、页面操作是本地没有的;Interact 可以先抓一页再按提示词或代码去点、去翻、去搜;Agent 不给 URL,只给一句需求,它自己去找;Monitor 是持续盯着页面变化。Alexandria 是 550 多个数据源,2.5 亿人、7500 万家公司、4100 万篇论文这类量级,发现工具免费,真正跑一次按标注的额度扣。云端还给了 96% 网页覆盖率、P95 3.4 秒延迟这类基准数字,以及每月 1000 次免密钥额度。
四、适合谁,不适合谁
适合正在搭知识库或者 RAG 的人。文档站、博客、产品手册这类结构清楚的站点,抓下来就是能直接切片的 Markdown。适合给 agent 加「读网页」能力的人,init 一条命令就把 MCP 配好,不用自己写胶水。适合在意数据不出本机的人,FIRECRAWL_CLOUD 设成 off 之后,抓取、解析、渲染全在自己机器上完成。也适合需要跑在自己机房、不想用托管服务的团队,Self-hosting 那条路是完整的。
不适合只想装个桌面软件点鼠标的人。它没有图形界面,release 页面也只有源码包和更新日志,没有现成二进制,装它等于装一套 Rust 工具链。不适合要结构化 JSON、截图、页面操作、Agent 这些能力的人,这些只在云端,本地做不到。不适合指望本地就能搜索的人,搜索是借云端完成的。也不适合一上手就要抓几十万页的人,Local 是单机方案,规模上去就该换云端或者自建集群。
五、几个需要提前知道的限制
第一是没有预编译二进制。想用 Local 就得有 Rust 和 C 编译器,第一次编译要等几分钟到十几分钟,机器慢的话更久。没有 Rust 环境又不想装,就只能走 npx 那条云端命令行,或者干脆用托管服务。
第二是浏览器。需要 JS 的页面靠本机已装的 Chrome 或 Chromium 渲染,机器上没有浏览器时,静态页面照样能抓,但需要渲染的页面会降级返回,并附一条警告。这不是报错,是能力缺了一块,看到警告就该知道那一页的内容可能不全。
第三是默认会回退到云端。这一点最容易被忽略:你以为全在本地跑,实际上打不开的页面被送到云端去了,结果里的 source 标记就是证据。对内容敏感的场景,必须显式关掉。
第四是本地没有搜索和 Alexandria。这两个都要连云端,Alexandria 还要先 login。Self-hosting 那套完整服务同样不含 Alexandria。
第五是许可。主体是 AGPL-3.0,SDK 和部分界面组件是 MIT。AGPL 对通过网络提供服务有额外要求,要商用或者做成对外服务,得先把这一条读明白。另外项目默认遵守 robots.txt,抓取行为合规与否由使用者自己负责。
六、项目现状
版本 v2.11.0,星标二十万五千八百多,主体许可 AGPL-3.0,SDK 部分是 MIT。平台是 macOS、Linux、Windows 上的命令行,没有图形界面。SDK 覆盖 Python、Node.js、Go、Java、Rust、Ruby、.NET、PHP、Elixir,异步任务由 SDK 帮你轮询。生态那侧有 MCP 服务器、命令行工具、技能目录,以及 Lovable、Zapier、n8n 这类平台的现成集成。项目更新频繁,具体能力和端口以项目文档为准。
七、常见问题
问:本地跑要不要钱?
答:Local 本身不要钱,装在自己机器上,抓取和解析都在本机完成。要花钱的是云端那部分:搜索、Alexandria、Interact、Agent 这些走托管服务,按额度算。默认的回退抓取不登录也能用,但有速率限制。
问:为什么抓下来的页面少了内容?
答:大概率是那一页需要 JS 渲染,而机器上没有可用的 Chrome 或 Chromium。静态部分还能抓,动态渲染出来的部分拿不到,结果里会给一条警告。装上浏览器再抓一次就能对比出来。
问:结果里的 source 字段是什么意思?
答:标成 firecrawl-cloud 就说明这一页不是在你机器上抓的,是本机打不开之后由云端代抓的。想全部留在本地,把 FIRECRAWL_CLOUD 设成 off,然后接受有些页面抓不到。
问:能不能只抓某个栏目?
答:crawl 有页数上限,先用 map 把 URL 列出来,筛出想要的路径再批量抓,比让整站爬一遍省时间也更可控。抓整站默认会遵守站点的 robots.txt。
问:接进 Claude Code 之后要做什么?
答:init 写完配置要重启那个工具,配置才会生效。它写之前会备份原文件,出问题可以照着备份回退。MCP 服务器本身要 Node.js 22 以上。
问:能拿它做对外服务吗?
答:技术上 serve 起的就是一套 v2 API。许可上主体是 AGPL-3.0,对外提供服务前先把许可条款读清楚,别等上线之后才发现要开放源码。
下载地址
夸克网盘(永久有效):https://pan.quark.cn/s/66a6fcca5414
本教程由「宝藏星球屋」整理,更多软件、游戏、开源项目都在 https://cbge.top。



暂无评论内容