
一、这个项目解决的是什么问题
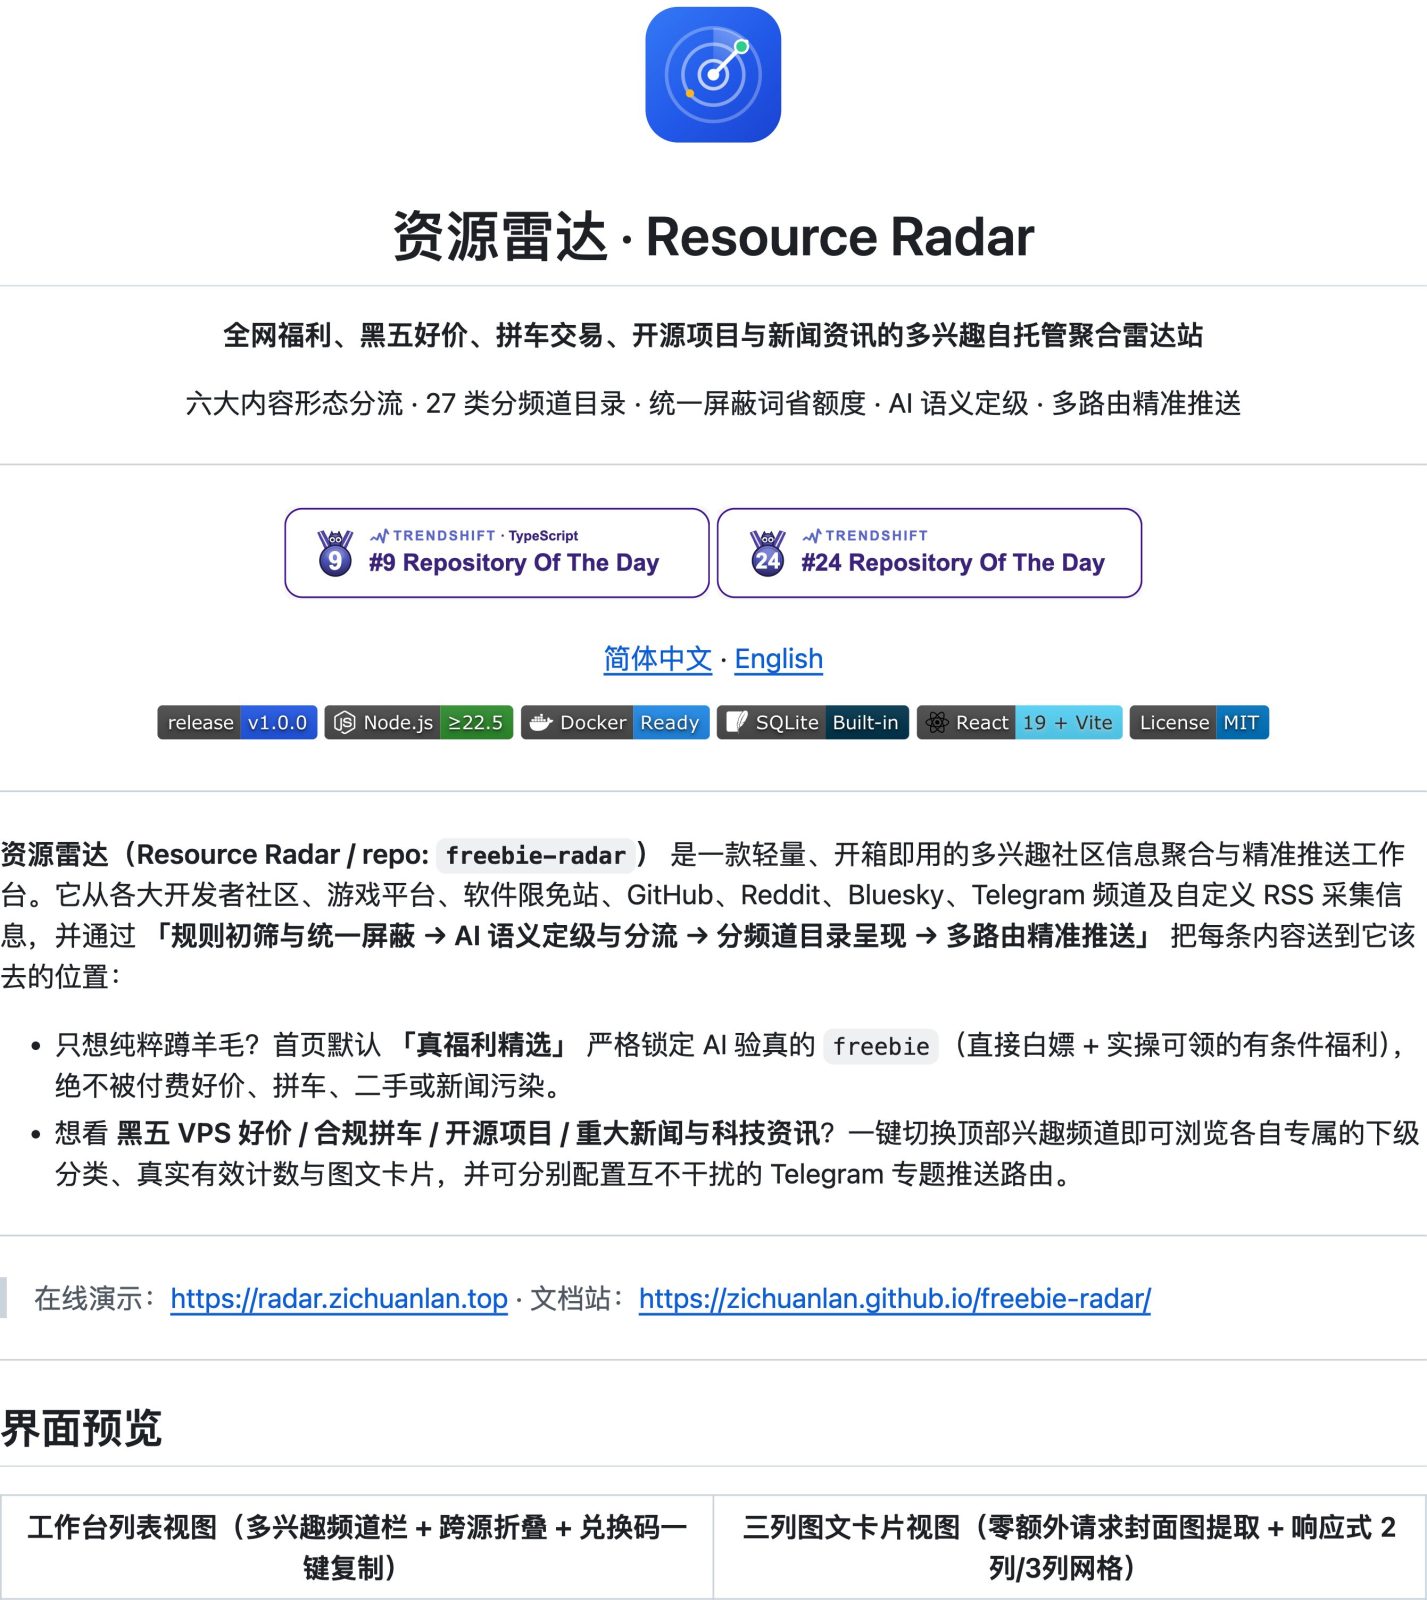
白嫖信息和好价信息散在十几个地方。LINUX DO 的福利帖、NodeSeek 的拼车交易、V2EX、NGA、B站的动态、微博、Telegram 频道、Epic 每周免费、Steam 打折、GamerPower 送 key、CheapShark 比价、Reddit、Bluesky,还有一堆 RSS。你要么全都盯着,一天刷几十次;要么干脆放弃,等别人转发到群里才发现错过了。资源雷达干的事就是把这一百多个源抓到一个地方,先按规则筛一遍,再让 AI 判断这条到底是真福利还是标题党,最后按你的兴趣分到八个频道里,要的话推送到 Telegram。
二、核心设计机制
它的管道是四段。第一段规则初筛:关键词、正则、分源规则,统一屏蔽词在这里生效,命中就直接跳过,连 AI 都不送,省额度。第二段 AI 语义定级:把标题和摘要丢给一个 OpenAI 兼容接口,让它输出保留还是丢弃、属于哪种形态、哪个领域、什么获取方式、质量几星,外加一句中文理由。第三段分频道:六种形态(白嫖福利、特价好价、开源、新闻、资讯、噪音)乘二十七个领域,组成八个兴趣频道。第四段推送:Telegram 上可以开多条路由,每条路由自己一套条件。
这套设计里最关键的一点是「获取方式」这一维度。它把福利分成免费、有条件、抽奖、试用、促销、付费六级。很多人被「免费」骗过——点进去发现要注册、要绑卡、要邀请五个人。有了这一层,你可以只留「无条件免费」,把「有条件」全滤掉。
三、功能拆解
界面上有三个视图,单行紧凑、两列、三列,选过就记住。十四路采集器在抓正文的同时顺手把封面抠出来,不多发一次请求。AI 审核可以随时关掉,白嫖专源默认免审直通。你收藏或者关掉某条,它会拿这个当偏好学习。分类跑偏了有个「重整分类(0 Token)」的入口,把历史上归到 other 的条目重新归位,不花额度。
推送这块做得比一般聚合器细。全局策略之外可以开多条专题路由,每条能设形态、分类、获取方式、关键词、最高价、最低分、即时推还是攒一批推、自定义前缀。推送前先过 AI 可以防误推;反过来抢码这类拼手速的场景,可以设成先推后审。AI 挂了有三种兜底:严格丢弃、退回纯规则、直接忽略 AI。攒批的会在发之前再校验一次,免得推出去的东西已经过期。夜里可以静默。
四、适合谁,不适合谁
适合爱捡漏又不想一天刷十个站的人。适合在群里当「消息源」的人——它能把符合条件的直接推到群里。适合想自己掌控数据的人,整套跑在自己机器上,数据在本地一个 sqlite 文件里。适合愿意花二十分钟配 AI 和 Telegram 的人。
不适合想要开箱就有一堆内容的人,第一次跑要等采集器抓完,头一两天数据是稀的。不适合完全不想碰命令行的人,虽然网页能操作大部分事,但启停、看日志、跑采集还是要在终端里。不适合指望它替你判断「这个东西值不值得买」的人,它只按你给的规则和价格上限筛,不替你做价值判断。也不适合想拿它抓需要付费订阅的内容的人,它抓的是公开页面和公开接口。
五、几个需要提前知道的限制
第一,它自己不产生内容,只聚合公开网页和公开接口,不存也不传播受版权的内容,也不提供账号共享。第二,涉及账号的地方要说清:默认部署下它不需要你任何账号。只有两种情况下会碰到账号——一是你想抓知乎、小红书、小黑盒这类必须登录才看得到的信息,那要用一个本地 Chrome 配置去扫码登录,登录态只留在你自己机器的一个目录里,服务端不保存 Cookie 和凭据;二是把站点切成公开模式,那需要配 LINUX DO 或 GitHub 的 OAuth 让别人登录,但 OAuth 只用来分用户,管理权限始终只认 ADMIN_TOKEN。第三,AI 审核要花钱,走的是你自己的接口,条目多的时候会有成本。第四,ADMIN_TOKEN 留空等于不设防,公网上必须设。第五,数据库是 sqlite,日常内存不到 100MB,但也别指望它扛几千人的并发。
六、项目现状
当前版本 1.0.0,星标 2048,许可 MIT。内置一百一十一个数据源,默认精选启用六十二个,其余可以按需打开。技术上用 Node 24 直接跑 TypeScript,内置 sqlite 开了 WAL,表结构版本到 30,升级时自动增量迁移。前端是 React 19 加 Vite 和 Tailwind v4,后端是 Hono。有在线演示站和一份文档站可以对照着看。
七、常见问题
问:它要我的账号吗?
答:默认不要。只有抓需要登录的站(知乎、小红书、小黑盒)时才用本地浏览器配置扫码,登录态留在本机目录,服务端不存 Cookie。公开模式下的 OAuth 是给别人登录用的,跟抓取无关。
问:AI 审核必须配吗?
答:不是必须。不配也能跑,全靠规则筛。配了之后假福利和标题党的过滤会明显好一些,代价是每条要花一点接口费用。白嫖专源默认免审,能省一部分。
问:会不会推一堆垃圾到群里?
答:取决于路由怎么设。把质量下限和价格上限都设上,再打开推送前过 AI,误推会少很多。刚开始建议只开一条路由,观察两天再放宽。
问:能抓需要登录才能看的内容吗?
答:能,但要你自己在本机扫码。它用一个持久化的浏览器配置去访问,登录态只在这个目录里。服务器定时任务模式下要挂一个目录给这个配置,不然每次都要重新登。
问:数据存在哪,升级会不会丢?
答:数据库是一个文件,默认在项目下的 data/radar.db,容器里是 /data/radar.db。升级时拉新代码重建容器,表结构自动迁移,数据不动。备份就是把这个文件拷走。
问:公网部署要注意什么?
答:三件事。ADMIN_TOKEN 必须设,留空等于谁都能改配置;建议前面加 HTTPS 反代;不确定的话把站点模式设成自用,别开公开模式。另外抓 Cloudflare 保护的站要额外起一个求解器容器。
下载地址
夸克网盘(永久有效):https://pan.quark.cn/s/eca031ac40ff
本教程由「宝藏星球屋」整理,更多软件、游戏、开源项目都在 https://cbge.top。




暂无评论内容