
一、这个项目解决的是什么问题
在自己电脑上跑大模型,卡住的从来不是"下载一个模型文件"。难的是后面那一串:要挑一个能跑的量化版本,要算显存够不够、内存够不够,要装对推理引擎和 CUDA 依赖,要知道上下文能开多长,要在模型慢的时候判断到底是显卡不够还是内存不够。每一步都能查,但每步都要自己拼。
PolyStrata 把这一串打包成一个安装器。下载 zip 解开,Windows 双击 START-HERE.bat,Linux 跑 ./setup.sh,它问你三个问题——用哪个模型、开多长上下文、要不要读图——回车就用推荐值,然后自己下权重、自己配引擎、自己起一个网页。开完浏览器访问本机 8080,就是一个能聊天的界面,同时在本机开出一个 OpenAI 兼容的接口,Claude Code、Codex CLI 这类工具可以直接指过来。
它不追求"跑最大的模型",而是追求"在你手上这台机器能跑起来的前提下,给你一个能用的本地模型"。
二、核心设计机制
第一层是两套引擎并存。默认的 Qwen3.8-Flash-Next 走 Strata 引擎,NVIDIA 和 AMD 显卡都行,要求 12GB 显存以上,Windows 和 Linux 都支持,能读图。另外 11 个模型跑在 PolyStrata 自研的引擎上,Linux 上全部可用,Windows 上除 GLM 5.3 Flash 和 DeepSeek V4 Flash 之外都能用——那两个太大,只给 Linux。
第二层是按机器给默认值。安装器不是让你从一堆参数里挑,而是按你机器的内存和显存推荐一个尺寸。32GB 内存配 Qwen3.8 就推 Coder 那个,48 到 64GB 推 IQ2_XS,96GB 以上才推 IQ3_S。这套推荐是它的主要价值之一,因为选错尺寸是新手最容易踩的坑:选大了跑不动,选小了白白浪费机器。
第三层是省内存的开关。从 0.1.45-poly.7 起它默认把一部分专家权重留在内存而不是全塞显存,Qwen3.6 在 32K 上下文之后的内存占用从 17.9GiB 降到 13.1GiB,Linux 上是 17.8 降到 12.6。还想再省就手动加参数,写进 strata-模型名.json 的 args 里,笔记本上能压到 6.5GiB,代价是写入速度慢百分之三到十四。
第四层是接口兼容。OpenAI 兼容的 base URL 是 http://127.0.0.1:8080/v1,key 随便填、模型名也随便填;Anthropic 那一套走 /v1/messages;Responses API 走 /v1/responses,给 Codex CLI 用。所以它不是又一个只能自己聊的界面,而是能给现有工具当后端。
三、功能拆解
十二个模型,各有各的用处。Qwen3.8-Flash-Next 是默认,能读图。GLM 5.3 Flash 权重 79 到 114GB,大部分留在内存,要 32GB 显卡加 96GB 内存,只有 Linux。DeepSeek V4 Flash 91GB,32GB 显卡加 72GB 内存,也只有 Linux。LFM2.5-24B-A2B 11 到 25GB,来自 Liquid AI,商用有年收入门槛。Flint 40B-A2.5B 18 到 42GB,面向编码 agent。Qwen3.6-35B-A3B 13 到 23GB,能读图。Clover-35B-A3B-Preview 13 到 21GB,只处理文本。Ornith 1.5 14 到 24GB。Gemma 4 26B-A4B 11 到 17GB。Tiel Coder 35B-A3B 14 到 23GB。MiniCPM-V 4.7 35B-A3B 16 到 29GB。Kolibri 1 29 到 48GB,来自 Aleph Alpha,德语和英语。
速度方面,笔记本那台 RTX 4070 8GB、i7-14700HX、32GB 内存的机器上,Qwen3.6 写能到 94 到 100 tok/s,读 prompt 1690;LFM2.5 写 70 到 73、读 3590 到 3620;Flint 61 到 63、读 2000;Gemma 4 92 到 93、读 2240。工作站 RTX 5090 32GB 上 GLM 是 59 到 66、读 820,DeepSeek 56、读 1040。Qwen3.8-Flash-Next 在 RTX 5070 12GB 加 64GB 内存上,IQ2_XS 尺寸写 79、32K 上下文读 2090。
界面上三个页签:Chat 聊天、Monitor 看运行状态、About 看版本和许可。装完会下权重,Qwen3.8-Flash-Next 大约 70GB,GLM 79 到 114GB,DeepSeek 91GB,Kolibri 29 到 48GB,其余八个 11 到 42GB。断了重跑会续传。
日常三条命令:START-HERE.bat 或 ./setup.sh 直接启动;UPDATE.bat 或 ./update.sh 更新;BENCH.bat 或 ./bench.sh 跑五到十分钟的基准。基准也能命令行跑:python polystrata.py benchmark --model 模型名 --prompt-tokens 24000。
还有两件配套的东西。一个是 MCP server,让 AI 工具能装卸、启停这些模型。另一个是 Linger,一个配套的个人 agent,有 macOS arm64、Windows x64、Linux x64 三个包。
四、适合谁,不适合谁
适合的人:手上有一张 12GB 以上的显卡,想在本地跑模型又不想天天修依赖;需要给 Claude Code、Codex CLI 这类工具一个本地后端,不想让代码出去;想试几个不同尺寸的模型,看哪个在自己机器上最划算;做实验、做对比,需要能一键切换模型和上下文长度。
不适合的人:显存不到 12GB 还想跑默认模型的,硬上只会很慢;只有集显或者老笔记本的,能跑但体验谈不上;指望它替代云端大模型的,本地模型的能力差距是客观的,它只是把"能用"这件事的门槛降下来了;需要多用户并发服务的,它是给一台机器一个人用的。
五、几个需要提前知道的限制
硬盘和内存要先算清楚。默认模型权重约 70GB,最大的 GLM 79 到 114GB,加上系统和别的软件,机器上留两三百 GB 才踏实。内存同样关键:Qwen3.8 的 32GB 内存只能上 Coder 那个尺寸,想上 IQ2_XS 得 48 到 64GB,IQ3_S 要 96GB 以上。GLM 和 DeepSeek 要 32GB 显卡加 72 到 96GB 内存,而且只有 Linux。
首次启动会卡。加载 35 到 55GB 的权重进内存还要锁一部分,PC 上卡一到三分钟是正常的,不是死了。等十分钟还没起来就重启,并换一个小一号的尺寸。
慢的时候先分清原因。如果很慢、磁盘灯一直在闪,那是内存不够在换页,关掉别的程序或者换 Q2_0、IQ2_XS 这种更小的尺寸。如果端口 8080 打不开,先确认它是不是已经在跑了,端口被占通常就是这个原因。
许可要分开看。项目本身是 MIT,但部分组件和每个模型各自另有许可。LFM2.5 的商用许可有年收入门槛,用之前去模型自己的页面确认一遍,别默认"MIT 就等于随便用"。
六、项目现状
当前版本 v0.1.45,星标 1317,MIT 许可,没有官网。发布页上只给了一个 Windows x64 的压缩包,Linux 和 macOS 走下载 zip 解压或者拉仓库自己构建。macOS 这条是 Apple Silicon 的 M1 到 M5、macOS 15 以上,要先装 Xcode 命令行工具,构建大约七分钟,默认跑 Qwen3.8-Flash-Next,也能用 --family qwen36 或 --family lfm25 走 Metal 的 beta 路径。
七、常见问题
问:显存 8GB 能跑吗?
答:能,但要选小尺寸。官方给的实测是在 RTX 4070 8GB 的笔记本上跑 Qwen3.6、LFM2.5、Flint、Gemma 4 这几个,尺寸选 UD-Q2_K_XL 或 UD-Q3_K_M 这一档,写入速度六十到一百 tok/s。默认的 Qwen3.8-Flash-Next 要 12GB 以上,8GB 跑不动。
问:为什么第一次打开这么久?
答:它在把权重加载进内存,35 到 55GB 的东西,还要锁住一部分防止被换出去,PC 上卡一到三分钟属于正常。等十分钟还没起来就重启,然后换一个小一号的尺寸重试。以后启动会快一些,但每次冷启动还是要等。
问:能不能给局域网里别的机器用?
答:能。启动时带上 --host 0.0.0.0 --api-key 你的密钥,Windows 上就是 START-HERE.bat --setup --host 0.0.0.0 --api-key 密钥。默认只听本机 127.0.0.1,改成 0.0.0.0 之后同一网段的设备就能连,但记得设 api-key,别裸着开。
问:Claude Code 怎么接?
答:把 ANTHROPIC_BASE_URL 指向 http://127.0.0.1:8080,另外在配置里加 "fit_max_tokens": true,不然它按云端模型的上下文长度要额度会失败。Anthropic 那套走的是 /v1/messages。Codex CLI 走 Responses API,也就是 /v1/responses。
问:内存不够怎么办?
答:三个办法。一是换更小的量化尺寸,Q2_0 或 IQ2_XS 这一档。二是手动限制留在内存里的专家权重,在 strata-模型名.json 的 args 里加 "--ram-experts-mib","6144",笔记本上能压到 6.5GiB,写入慢百分之三到十四;"--ram-experts-mib","-1" 是恢复全映射。三是关掉别的吃内存的程序。
问:模型能读图吗?
答:看模型。Qwen3.8-Flash-Next 能读图,Qwen3.6-35B-A3B 能读图,MiniCPM-V 4.7 是视觉模型。Clover-35B-A3B-Preview 只处理文本。安装器会问要不要读图,选了不支持读图的模型那一步就没意义,所以装之前先看模型说明。
下载地址
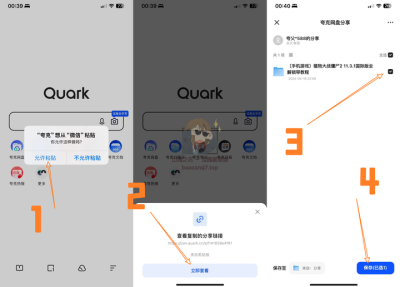
夸克网盘(永久有效):https://pan.quark.cn/s/892e711a69f7
本教程由「宝藏星球屋」整理,更多软件、游戏、开源项目都在 https://cbge.top。

暂无评论内容