
一、问题是什么
早些年做网页自动化,发个 HTTP 请求就够用了。现在不行了,JavaScript 撑起了大半个互联网:Ajax、单页应用、无限下拉、输入即搜,还有 React、Vue、Angular 写的页面。想拿到真实内容,就得跑一个能执行脚本的浏览器。可把完整桌面浏览器搬到服务器上跑,成本太高:内存和 CPU 吃得厉害,几百上千个实例撑不住,部署维护都麻烦,无头场景里一大半功能还用不上。这就是 Lightpanda 要解决的矛盾:既要有脚本执行能力,又不能背着桌面浏览器那身包袱。它的目标很清楚,就是一个给自动化和 AI 代理用的轻量无头浏览器。
二、核心设计/机制
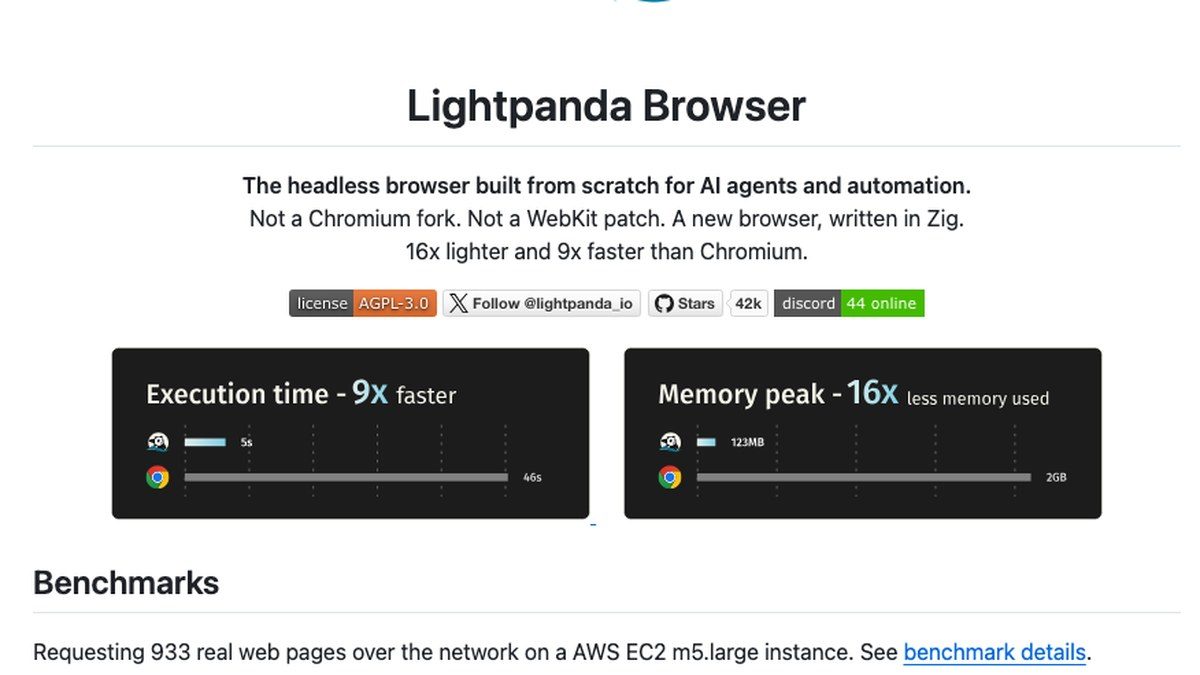
它的思路不是把 Chrome 裁剪一圈,而是从零写一个浏览器。语言选了 Zig,够底层,内存怎么分配自己说了算。零件则是能复用就复用:网络请求交给 Libcurl,HTML 解析用 html5ever,脚本执行用 V8,自己写的是把这些成熟部件串起来的浏览器主体。最关键的一个取舍,是它压根没有图形渲染引擎。桌面浏览器一大半的重量都花在画界面上,而自动化任务根本不用看画面,把这块整个砍掉,体积和开销就断崖式往下掉。它也不基于 Chromium、Blink 或 WebKit。这么设计的效果,官方基准里抓 100 个页面峰值内存是 123MB,无头 Chrome 要 2GB;耗时 5 秒对 46 秒,大约轻 16 倍、快 9 倍。这组数字是在一台 AWS EC2 m5.large 上请求 933 个真实网页测出来的,不是实验室里的空口数据。
三、功能拆解
- 能跑现代网页:支持 JavaScript(V8 引擎)、DOM 树和 DOM 接口,还有 XHR、Fetch 这类 Ajax 请求,单页应用和异步加载的内容也抓得到。
- 抓取命令好用:fetch 能把页面导成 html、markdown、png、pdf,还能导出 structured_data,把 JSON-LD、OpenGraph、Twitter card、meta 和 link 标签整理成一份 JSON。
- 等待机制齐全:可以按加载状态等、等固定毫秒、等某个选择器出现,或者等一段脚本为真,再决定什么时候动手抓。
- 标准自动化接口:提供 CDP 和 websocket 服务,也能开 Webdriver Bidi;Puppeteer、Playwright 换个连接地址就能接上,已有脚本大多能接着用。
- Agent 模式:用大白话或斜杠命令让它自己翻页、点按钮、填表单、抽数据;跑完能导出一段叫 PandaScript 的普通 JavaScript,用 run 命令在没有模型的情况下重放,结果确定,运行时不花 token。
- 原生 MCP 支持:服务端走 stdio 或 HTTP;HTTP 模式下每个连接是一个独立会话,页面、Cookie、内存互不干扰,也能让几个代理共享同一个会话。
- 网络控制到位:支持代理、自定义 HTTP 头、网络拦截和 Cookie,还能用 obey-robots 遵守网站的 robots.txt,内置广告过滤。
- 配套比较全:官方 Docker 镜像覆盖 amd64 和 arm64,另有 Nix、Homebrew 等方式,bash、fish、zsh 的补全脚本也能直接生成。
四、适合谁、不适合谁
适合的人很明确:要大规模抓取、爬网页、跑自动化流程的开发者和运维;想把 AI 代理接上网页、把浏览器塞进大模型或 MCP 工具链的应用开发者;还有那些被服务器内存和 CPU 卡住、觉得无头 Chrome 太重的团队。不适合的人也一样清楚:要真实图形渲染、要视觉还原、要完整桌面浏览器和扩展生态的,它给不了;依赖原生 Windows 桌面程序,或者想在 Android、Termux 上直接跑的,得绕道 WSL2 或换 glibc 环境;需要正式稳定版和完整 Web 平台兼容承诺的生产系统,眼下也要谨慎,因为它毕竟还是 nightly 预发布。一句话,冲着轻和快来就用,冲着像真人浏览器一样看页面就别指望它。
五、诚实提醒
先把预期放平。它目前是 nightly 预发布,版本迭代快,生产稳定性和完整兼容性都得自己验证,官方是靠每天发布 Web Platform Tests 结果来跟踪进度的。平台上有硬限制:没有原生 Windows 和 Android 构建,Windows 要先装 WSL2,Android 和 Termux 因为缺 glibc 加载器直接跑不起来。发布出来的二进制依赖 glibc,x86_64 要 2.35、arm64 要 2.38,Alpine 这类 musl 系统会报 required file not found,得换基础镜像或者从源码编译。另外它没有图形渲染引擎,导出的 png、pdf 是纯文本渲染,想要真实截图还原度的话会失望。还有一点值得知道:它默认会收集并发送用量统计,介意的话可以用环境变量关掉。
六、项目现状
项目在持续维护,功能清单还在往外扩,兼容性用每天发布的 Web Platform Tests 结果公开跟踪,看得出是有人在认真推进的。许可方面,README 把它作为开源项目呈现,带 LICENSE 文件和 open-source 文档,没有提到付费墙或者许可费,具体条款以项目文档为准。star 数 README 里没有给出具体数字,只放了一个展示用的徽章,想看准确数字以项目页面为准。要提醒的是,它眼下走的仍是 nightly 预发布通道,正式版的节奏也以项目文档为准。
七、常见问题
问:它跟无头 Chrome 到底差在哪?
答:不是同一套东西。它不是 Chrome、Chromium 或 WebKit 的分支,而是用 Zig 从零写的,还没有图形渲染引擎。官方基准里 100 个页面内存 123MB 对 2GB,耗时 5 秒对 46 秒。
问:能接 AI 代理和大模型吗?
答:能。agent 模式支持 Anthropic、OpenAI、Gemini、Vertex AI、Mistral、Hugging Face,还有 Vercel AI Gateway、OpenRouter、任意 OpenAI 兼容端点,以及本地的 Ollama、llama.cpp、LLMD;也能用它自带的 MCP 接口接进来。
问:不接大模型还能用吗?
答:可以。带上 no-llm 参数会直接进到一个基础交互界面,不挂任何模型;跑 PandaScript 脚本的时候也完全不需要模型参与。
问:支持哪些操作系统?
答:nightly 二进制有 Linux 的 x86_64 和 aarch64、macOS 的 aarch64 和 x86_64,另外有 Docker 镜像和 Nix。没有原生的 Windows 和 Android,前者要走 WSL2,后者因为缺 glibc 加载器跑不了。
问:默认会不会收集我的数据?
答:会。它默认就会收集并发送用量统计,可以用 LIGHTPANDA_DISABLE_TELEMETRY 环境变量关掉;具体的隐私条款以项目文档为准。
下载地址
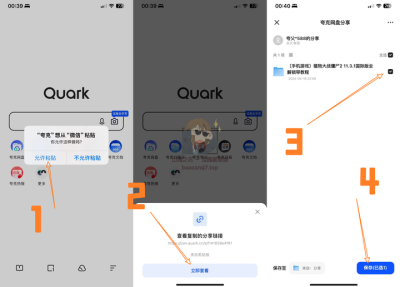
夸克网盘(永久有效):https://pan.quark.cn/s/91444e0386c3
本教程由「宝藏星球屋」整理,更多软件、游戏、开源项目都在 https://cbge.top。



暂无评论内容