
Graphify 是一个 Claude Code 技能。装上之后在对话里敲 /graphify,它就把你指的那个文件夹——代码、PDF、Markdown、截图、手绘图,甚至别的语言的图片——全部读一遍,抽成一张知识图谱。
一、问题是什么
AI 编程助手有个绕不过去的物理限制:上下文窗口。你让它改一个函数,它得先知道这个函数被谁调用、依赖什么、改完会波及哪里。而要知道这些,它得把相关文件都读进来——一个大一点的仓库,光是把调用链摸清楚就能把窗口吃光。
于是现实里就出现两种尴尬:小项目还行,一进中型仓库助手就开始瞎猜;或者你手动挑几个文件喂给它,挑漏了它就给你一个「局部正确、全局错误」的改法。
更麻烦的是资料类型混杂。真实项目里除了代码还有 PDF 论文、Markdown 笔记、设计图截图——这些东西之间本来是有关系的,但助手没法同时「看懂」它们并建立联系。
二、核心设计
Graphify 的思路不是「压缩上下文」,而是「换一种表示」:把文件集合变成一张图,之后查询图,而不是反复读原文。
具体分两层:
代码层完全本地、不花模型额度。 它用 tree-sitter 做 AST 解析,做一次调用图分析。这部分是确定性的,不需要 LLM,代码也不离开你的机器。
文档和图片层用模型。 Markdown、PDF、图片交给你的助手(或你自己配的 API key)做语义抽取,把概念和关系提出来。
两层的结果合并成一张图,每条边打个标签:EXTRACTED 表示原文明说的,INFERRED 表示是它推断的,AMBIGUOUS 表示拿不准。这个标签体系是整个设计里最值得说的部分——它让你能分清哪些是事实、哪些是猜测。
生成的东西不止一种格式:能点的交互图(graph.html)、Obsidian 库、给 agent 导航用的维基(--wiki)、持久化的 graph.json、以及一份 GRAPH_REPORT.md(枢纽概念、意外连接、建议提问)。
三、功能拆解
- 一行命令建图:
/graphify .对任意文件夹生效。 - 省 token:官方实测在一个混合语料(52 文件,含代码+论文+图片)上,用图查询比直接读原文件省 71.5 倍 token。
- 增量更新:
--update只处理变动的文件,不重建整张图。 - 自动跟随:
--watch在后台跟着文件变化更新(代码改动即时重建且不花模型,文档改动会提醒你跑 update)。 - 多格式导出:graph.svg、graph.graphml(给 Gephi/yEd)、Neo4j 的 cypher.txt。
- MCP 服务:
--mcp起一个 stdio 服务,别的 agent 可以连。 - Git 钩子:
graphify hook install装 post-commit 钩子,每次提交自动重建。 - 随手加料:
/graphify add能直接抓一篇论文或推文进来并更新图。
四、适合谁、不适合谁
适合:要在中型以上仓库里做重构、需要助手真正理解全局关系的人;做研究、手上堆了一堆论文和笔记需要串联起来的人;同时写代码和文档、想让两者连起来的团队;想让多个 AI agent 并行工作、需要一个共享知识底座的场景。
不适合:小项目——官方自己承认,6 个文件的时候几乎没压缩收益,图的价值只是结构清晰;只想让 AI 帮忙改个 bug、不想引入额外步骤的人;完全不用 Claude Code 的人(虽然文档提到兼容 Cursor/Codex/Gemini CLI,但主线是 Claude Code)。
五、诚实提醒
省 token 的倍数强依赖语料规模。 官方给的三个例子很诚实:52 个文件是 71.5 倍,4 个文件是 5.4 倍,6 个文件约 1 倍。文件越少,图的收益越低,别被单个大数字带跑。
图片和 PDF 的抽取质量取决于模型。 这部分不是确定性的,同一份材料不同模型抽出来的概念可能不一样。官方也坦白说了,INFERRED 的边是猜出来的,用之前要看标签。
包名现在叫 graphifyy。 PyPI 上 graphify 这个名字还在回收流程里,所以临时用了 graphifyy。这是个临时状态,不是拼写错误。
Mac 上 pip install 可能失败。 苹果的系统 Python 是「外部管理」的,会报 externally-managed-environment,正确解法是 pipx install graphifyy。
它有个商业产品。 README 里推广了 Graphify Cloud(常驻记忆、跨仓库、形式化验证等),那部分要付费。开源技能本身能用,不要把两者搞混。
六、项目现状
用 Python 写成,Apache-2.0 协议,star 数约 14.7 万,最新版本 v0.9.108——这个版本号说明它更新非常频繁(0.9.x 已经到 108 了)。技术栈是 NetworkX + Leiden(graspologic)+ tree-sitter + 模型 + vis.js,不需要 Neo4j、不需要服务器,完全本地跑。
发布页提供 wheel 和 tar.gz,另有一个 graphify-self-graph.tar.gz(用自己的图分析自己)。
七、常见问题
问:包名 graphifyy 是不是拼错了?
答:不是,PyPI 名字回收期间的临时方案,命令行和技能名仍然是 graphify。
问:一定要 Claude Code 吗?
答:目前主线是 Claude Code 技能。代码解析部分是本地 AST,不依赖模型;文档和图片的语义抽取才需要模型。
问:它会不会把猜的当成事实?
答:每条边都带 EXTRACTED / INFERRED / AMBIGUOUS 标签,你能分清。
问:小项目有必要吗?
答:文件少的时候收益不明显,官方自己给的数据是 6 个文件近乎 1 倍。
问:代码会被上传吗?
答:代码的 AST 解析全在本地,不上传。文档、PDF、图片的语义抽取会走模型,这部分取决于你配的是哪个模型。
下载地址
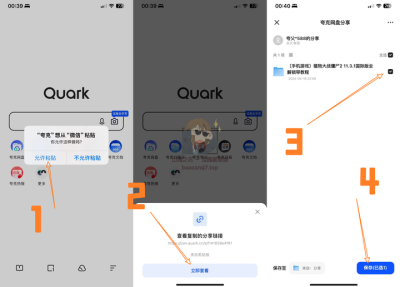
夸克网盘(永久有效,无提取码):https://pan.quark.cn/s/2ebe2cab9f76
本文由「宝藏星球屋」整理,更多软件、游戏、开源项目都在 https://cbge.top。

暂无评论内容